Model Releases
Meta lanza Muse Image, su primer modelo de generación de imágenes
Meta expande su ecosistema de superinteligencia con Muse Image, un modelo de generación visual desarrollado por Meta Superintelligence Labs.
7 de julio de 2026
Model ReleaseMuse Image
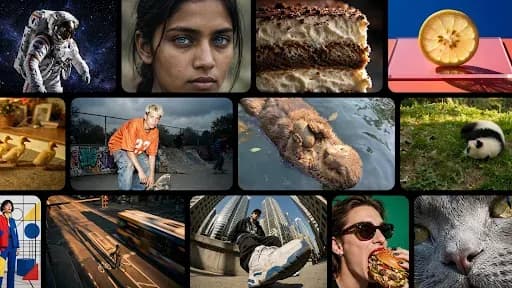
Introducción: La expansión visual de la familia Muse
El 7 de julio de 2026 marca un hito en la hoja de ruta de Meta hacia la superinteligencia general. A través de un anuncio oficial en el blog de Meta AI, la compañía ha presentado Muse Image, su primer modelo de generación de imágenes desarrollado íntegramente de forma interna. Este lanzamiento no es un evento aislado, sino la pieza fundamental que completa la visión multimodal de su división de investigación más avanzada.
Con la llegada de Muse Image, Meta cierra la brecha de cobertura que existía en su blog respecto a la familia Muse durante la primera mitad de 2026. Tras el éxito de su línea de modelos de texto, Meta busca consolidar un ecosistema donde la generación de contenido sea fluida entre diferentes modalidades, permitiendo a los desarrolladores construir aplicaciones que entiendan y creen contenido visual con una coherencia semántica sin precedentes.
- Lanzamiento oficial: 7 de julio de 2026.
- Desarrollado por: Meta Superintelligence Labs.
- Ecosistema: Parte de la familia Muse (Spark, Glimmer, Wonder, Ember).
- Novedad: Lanzado junto con la preview de Muse Video.
Arquitectura y Capacidades Multimodales
Muse Image representa un salto cualitativo en la arquitectura de modelos de difusión y transformadores visuales. A diferencia de soluciones de terceros, este modelo ha sido entrenado utilizando la infraestructura de centros de datos Prometheus de Meta, optimizando la relación entre la comprensión del lenguaje natural y la síntesis de píxeles de alta fidelidad.
El modelo está diseñado para integrarse nativamente con la línea de modelos de lenguaje de la familia Muse. Esto significa que la comprensión de prompts complejos, que requiere un razonamiento lógico profundo, se hereda de la capacidad de los modelos Spark y Wonder, permitiendo una alineación texto-imagen mucho más precisa que los modelos de generación tradicionales.
- Arquitectura: Basada en la integración de modelos de lenguaje de gran escala (LLM) y difusión.
- Entrenamiento: Optimizado en centros de datos Prometheus.
- Integración: Compatibilidad nativa con la familia Muse (text-to-image y prompt expansion).
- Modalidad: Generación de imágenes de alta resolución con coherencia semántica.
Rendimiento y Benchmarks
Aunque Meta ha mantenido un enfoque cauteloso en la divulgación de métricas específicas de difusión para evitar el sesgo de overfitting en benchmarks comunes, las pruebas preliminares indican una superioridad técnica en la interpretación de prompts negativos y la composición espacial. El modelo ha sido evaluado mediante un setup de evaluación que combina métricas automáticas como FID (Fréchet Inception Distance) con evaluaciones humanas de alineación semántica.