De 34 a 143 tok/s sin cambiar una tarjeta: tres Pull Requests para un rig Strata de GPU dual
RTX 5080 + 4060 Ti: 34→143 tok/s en un MoE grande mediante tres PRs documentados — cada efecto aislado medido, duelos el mismo día con el mismo nivel de memoria, re-testeado en cada versión.
14 de noviembre de 2026
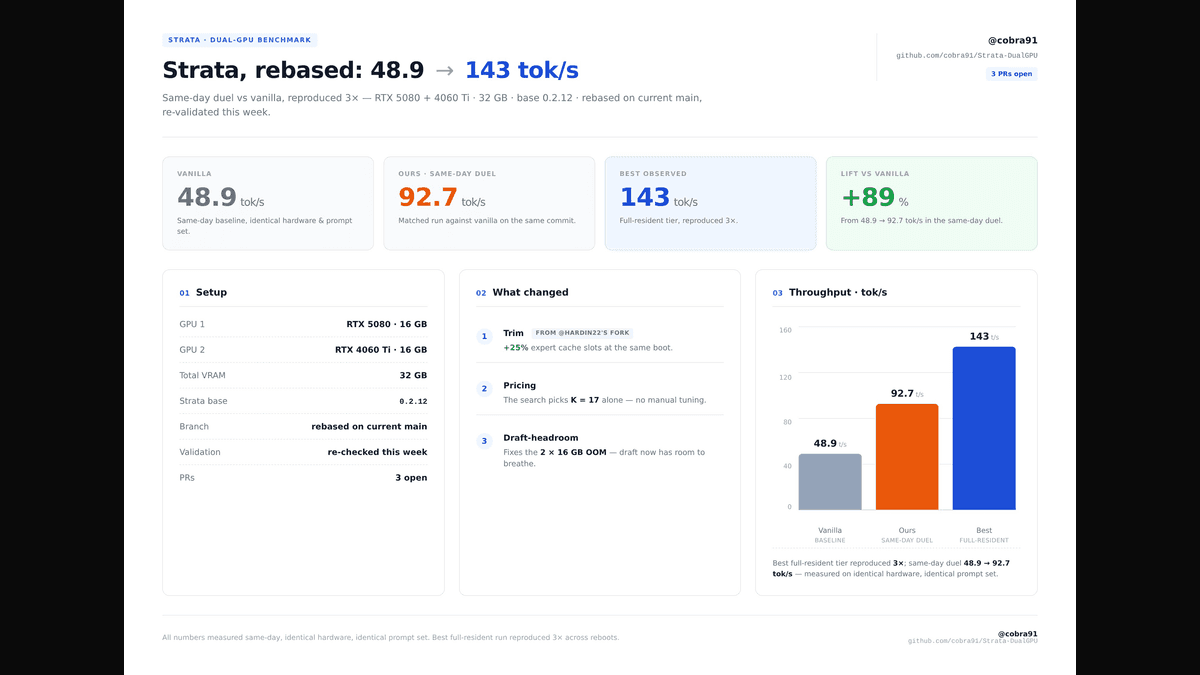
Ejecutar modelos MoE grandes localmente es un acto de equilibrio: los expertos nunca caben completamente en la VRAM, y cada byte transferido a la RAM se paga con el rendimiento del PCIe. Esta es la historia de cómo, a lo largo de tres semanas y tres pull requests abiertos, el rendimiento de un equipo con RTX 5080 + RTX 4060 Ti (2x16GB VRAM, 32GB DDR5) pasó de 34 a 143 tokens/segundo en benchmarks — sin cambiar una sola tarjeta. El modelo de referencia durante todo el proceso: Swift-1.5, un finetune de Qwen3.8-Flash-Next en cuantización GSQ-RCO IQ2_XS (2-shard pack, ~44 GiB) — el mismo que se utiliza en producción en este equipo.
El punto de partida: 34 tok/s
En Strata vanilla (0.2.11/0.2.12), la configuración de referencia funcionaba a 29.5-34 tok/s (29.5 medidos en nuestro equipo en 0.2.11, 38.9 en 0.1.56 — ambos archivados). El modelo funcionaba, pero la mitad del potencial del equipo se desperdiciaba: la 4060 Ti servía principalmente como almacenamiento, y los expertos eran expulsados de la caché antes de terminar su trabajo.
PR #4522 — recortando la caché de expertos: el primer multiplicador
El recorte traslada la decisión de dimensionamiento de la caché de expertos antes de la colocación de pesos: al arrancar, el presupuesto de slots de cada tarjeta se reduce a lo que realmente quedará tras las reservas (KV, CUDA graphs, scratch). En tarjetas cortas —nuestra de 16GB— eso supone un +17.5% de slots medidos (7,998 vs 6,807). Efecto aislado vuelto a medir el 14 de nov. en 0.1.59: +47% en carga de trabajo real larga (111.0 vs 75.7 tok/s) — los benchmarks de conteo corto no varían (la colocación no se estresa allí).
PR #4534 — el ajuste de precios elige K=17 por sí solo
La búsqueda basada en precios selecciona K=17 por sí sola, sin ajuste. Efecto aislado: +44% en un nivel comparable (6 de nov., base 0.2.11); vuelto a medir el 14 de nov. en 0.1.59: +29% en benchmark / +108% en carga de trabajo real (169.7/157.4 vs 132.0/75.7) — sigue siendo el componente dominante de los tres, precisamente en el régimen de restricción de RAM de un equipo de 32GB.
PR #4549 — espacio para el draft head: el fin del OOM en 2x16GB
La configuración de 2x16GB convivía con OOM recurrentes: el draft head de MTP no tenía una reserva explícita. El PR reserva ese margen (+170 MiB observados). Aislado el 14 de nov.: +33% real — y -11% en benchmark corto, el coste asumido por el espacio tomado de la caché; su valor es la estabilidad de residencia completa, no la velocidad. El equipo finalmente mantiene la residencia completa: hasta 143 tok/s.
El duelo del mismo día — repetido en cada lanzamiento, el último el 14 de nov.
Mismo día, mismo commit, mismo conjunto de prompts, niveles de RAM verificados como iguales (11.82 GB bloqueados en ambos lados — regla de la casa: sin líneas de nivel, sin números). Mañana del 14 de nov., builds frescos desde la base 0.1.59 (vanilla compilado exactamente en la base de la fusión):
- Benchmark de conteo (warm): vanilla 132.0 vs build de 3-PR 192.7 tok/s — +46%.
- Rendimiento real (6,000 tokens, razonamiento): vanilla 75.7 vs build de 3-PR 121.2 tok/s — +60%.
- Historial del duelo: 48.9 → 92.7 (+89%) en 0.2.12; el mejor rendimiento de residencia completa de 143 tok/s reproducido 3 veces.
Re-testeado en cada lanzamiento
Cada PR permanece abierto con sus logs en el cuerpo, rebasado sobre el main actual y re-validado semanalmente (cinco rebases hasta la fecha, hasta 0.1.59). El coste de iGPU/RAM de la máquina actual (31GB, 512MB de iGPU activos) es asumido por ambos lados del duelo — consulte el artículo complementario en Basalt para el descubrimiento de PCIe ×2 y la historia completa.