La 4060 Ti aprendió a computar: Basalt supera a Strata en nuestro equipo — Evidencia y protocolo
Mismo equipo, nuevas builds, niveles verificados: Basalt alcanza 161-174 real tok/s frente a los 121.2 de Strata (207.5 vs 192.7 bench, 348 structured fixtures) — debido a que un PR hace que la 4060 Ti compute, además de un descubrimiento de PCIe ×2 y ajuste basado en fixtures.
14 de noviembre de 2026
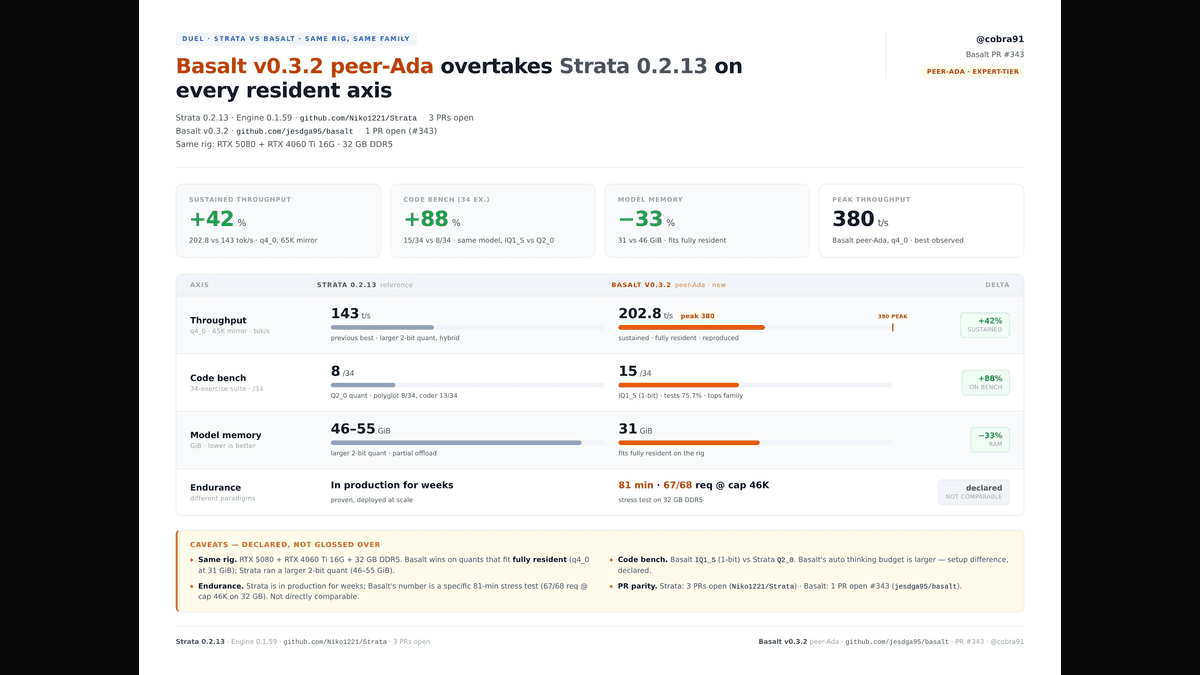
Hay dos formas de comparar motores de inferencia locales: leer benchmarks o escribirlos. Esta comparación proviene de un equipo con RTX 5080 + RTX 4060 Ti (2x16GB) + 32GB DDR5, con una peculiaridad declarada: su autor tiene pull requests abiertos en ambos lados —tres en Strata (#4522, #4534, #4549), uno en Basalt (#343). Cada diferencia en la configuración ha sido declarada.
Antes: una tarjeta más, cero cómputo adicional
Los kernels "peer" de Basalt nunca se habían compilado para sm_89 —la arquitectura Ada de la 4060 Ti. En la práctica, la tarjeta era solo un nivel de VRAM leído a través de PCIe: almacenamiento, no cómputo. El trabajo de MoE recaía enteramente en la 5080.
PR #343: compilando los kernels peer para Ada
El fork permite peers sm_89/sm_120, construye los kernels peer/MMQ y la ruta completa de prompt para Ada, con clusters/TMA compilados fuera por debajo de sm_90. Resultado: la 4060 Ti ahora computa nativamente las ventanas de expertos MoE —Q8_1/Q2_0 en dp4a, CUDA estándar. Una tarjeta de "almacenamiento" se convierte en un nivel de cómputo de 14.5 GiB. Este único cambio explica el giro: 50.5 → 164 tok/s en la primera sesión, antes de cualquier ajuste.
La noche de ajuste: eliminando crashes mediante el movimiento del KV
Los crashes en conversaciones largas tenían una causa sorprendente: el motor reportaba "otros programas ocuparon 4.8 GiB" —pero ningún programa se estaba ejecutando. Era el propio motor: el KV más allá de la celda 30,000, fijado en RAM, consumía el margen del watchdog en cada conversación larga —y el watchdog no cuenta sus propias asignaciones. La prueba diferencial: cambiar kv-resident a 42000 (KV en VRAM, reservas de GPU en 256) sin cerrar un solo programa llevó las solicitudes cap-6000 de una "ruleta rusa" a 4/4. El diagnóstico completo se reportó upstream (issue #353).
Ajuste mediante fixtures oficiales: tres palancas, cada una medida
El protocolo basalt-probe + basalt-bench (fixtures de conv/struct/prose, ABAB) reveló y luego validó tres palancas:
- La 4060 Ti está en un slot PCIe 4.0 ×2 —3.2 GB/s frente a 28.9 para la 5080. Visible en cada dashboard (Gen4x2) pero nunca notado. Consecuencia: congelar sus swaps de adaptación (--peer-adapt-swaps 0) —la tarjeta mantiene sus 11,194 expertos más calientes y ya no asfixia su propio bus; la 5080 sigue adaptándose a ancho de banda completo.
- spec 4 → 8: en contenido estructurado (JSON, código, razonamiento paso a paso), la aceptación del drafter supera el 95% —la ventana de verificación más larga promedia 6.8 tokens por ciclo: los fixtures estructurados saltan de 237 a 348 tok/s (+47%).
- Corrección de pool PR #328 (un despertar perdido en la barrera del worker de la CPU): +11% en prosa —desaparecen los micro-stalls de 10ms.
Y un contraresultado útil: KV NVFP4 (#314, 0.55 GiB) pierde contra int8 en contextos de 65K (297 vs 348 estructurados) —sigue siendo el arma para contextos de más de 131K.
Los números —builds recientes, misma mañana del 14 de nov, carga de trabajo de pensamiento largo
- Rendimiento real (prompt técnico, razonamiento, temp 0): Strata 0.1.59 3-PR 121.2 tok/s — Basalt final 161-174 tok/s.
- Bench de conteo (warm): Strata 192.7 tok/s — Basalt 207.5 tok/s.
- Fixtures oficiales (conv/struct/prose): 157 / 348 / 146 tok/s.
- Prefill 16K: 1,393 tok/s.
- Receta final: kv int8 elastic (todo en VRAM), spec 8, pool 7, peer-adapt-swaps 0 (4060 Ti es PCIe ×2), budget 8.15, reserves 256/128. La secuencia cap-6000+image+text pasa 5/5 (174/161/164/161 t/s).
El protocolo de duelo (lo que hace que los números sean comparables)
- Misma tarde, misma máquina (iGPU activa de 512MB, 30.9 GB RAM), ambos motores compilados el mismo día.
- Dos tipos de contenido etiquetados: conteo (aceptación del drafter ~99%) y razonamiento real (59-66%) —ambos reportados, nunca mezclados.
- Cold y warm distinguidos; el orden de lanzamiento es una variable (ambos motores congelan su nivel en la RAM libre al arrancar).
- Línea de nivel verificada al arrancar ("file (SSD) 0.0 GiB" = válido); guardia de 2GB RAM = suelo anti-muerte.
Memoria: -33%, y totalmente residente
Donde la configuración de referencia de Strata despliega un quant de 2 bits más grande (~44 GiB, offload parcial), el Basalt final cabe en 31 GiB, enteramente residente. Menos RAM de modelo, menos PCIe, más cómputo local.
El bench de código: el de 1 bit que vence al de 2 bits
En nuestra suite de código de 34 ejercicios (políglota, temp 0, pytest como juez), mismo modelo base: Basalt IQ1_S 15/34 —75.7% de las pruebas pasaron, la mejor puntuación de la familia en esta suite —frente a 8/34 para Q2_0 en Strata. Declarado: el presupuesto de pensamiento automático es mayor en Basalt (~34,500 vs 4096); el duelo con presupuesto igual está pendiente de realizarse.
Resistencia: el eje no comparable (asumido)
Strata ha estado funcionando en producción durante semanas. Basalt final tiene una prueba de estrés dedicada: 81 minutos, 67/68 solicitudes con un límite de 46K. Estos dos hechos no son comparables —y el artículo así lo dice.
Veredicto por caso de uso
- Rendimiento real de pensamiento largo en este equipo: Basalt final, 161-174 vs 121.2 tok/s (Strata 3-PR, misma mañana, mismo nivel).
- Producción probada a largo plazo: Strata, hoy.
- Las lecciones van más allá de ambos motores: comprueba que tus kernels se compilen para la arquitectura de tu segunda tarjeta —y lee la línea PCIe en tus dashboards: un slot discreto ×2 limitó esta tarjeta durante semanas sin que nadie lo notara.
Reproducción
Basalt final (peer-ada fork, PR #343): basalt_serve.json — model Qwen3.8-FN-UD-IQ1_S en GPU 0,1, kv int8, max-context 65536, vision dynamic; engine: resident-experts true, pool-workers 7, spec 8, expert-cache auto, prefill auto, resident-budget-gib 8.15, peer-adapt-swaps 0, vram-reserve-mib 256, peer-reserve-mib 128. Verificar al arrancar: "experts live in ... file (SSD) 0.0 GiB" y "RAM X GiB free, guard 2.00 GiB".
Strata hybrid 0.1.59 (3 PRs): STRATA_RESIDENT_HEADROOM_GIB=4, python serve/server.py --engine strata --config engine_swift_prod.json --port 18503. Bench code: python polyglot_runner.py --name <run> --url http://127.0.0.1:8644/v1 --model "Qwen3.8-Flash-Next UD-IQ1_S" (pytest como juez).