Model Releases
Claude Opus 5.5 : La Révolution du Code et de l'Alignement chez Anthropic
Découvrez Claude Opus 5.5, le nouveau modèle d'Anthropic qui redéfinit les standards du développement logiciel avec des performances de niveau Fable à un coût réduit de 40%.
22 septembre 2026
Model ReleaseClaude Opus 5.5
Introduction : Un nouveau jalon pour l'IA générative
Le 22 septembre 2026 marque un tournant historique dans l'industrie de l'intelligence artificielle. Anthropic vient de lever le voile sur Claude Opus 5.5, un modèle qui ne se contente pas d'améliorer ses prédécesseurs, mais qui redéfinit la relation entre coût, performance et sécurité.
Alors que la course à la puissance s'intensifie, Anthropic a choisi une voie différente : celle de la maîtrise et de l'alignement rigoureux. Après avoir appelé à un rythme de développement prudent pour la frontière technologique, l'entreprise prouve que la prudence n'est pas un frein à l'innovation, mais un catalyseur de fiabilité pour les déploiements en production à grande échelle.
- Date de sortie : 22 septembre 2026
- Catégorie : Modèle de codage et de raisonnement avancé
- Statut : Premier modèle de la famille Claude 5.5
Architecture et Philosophie de Conception
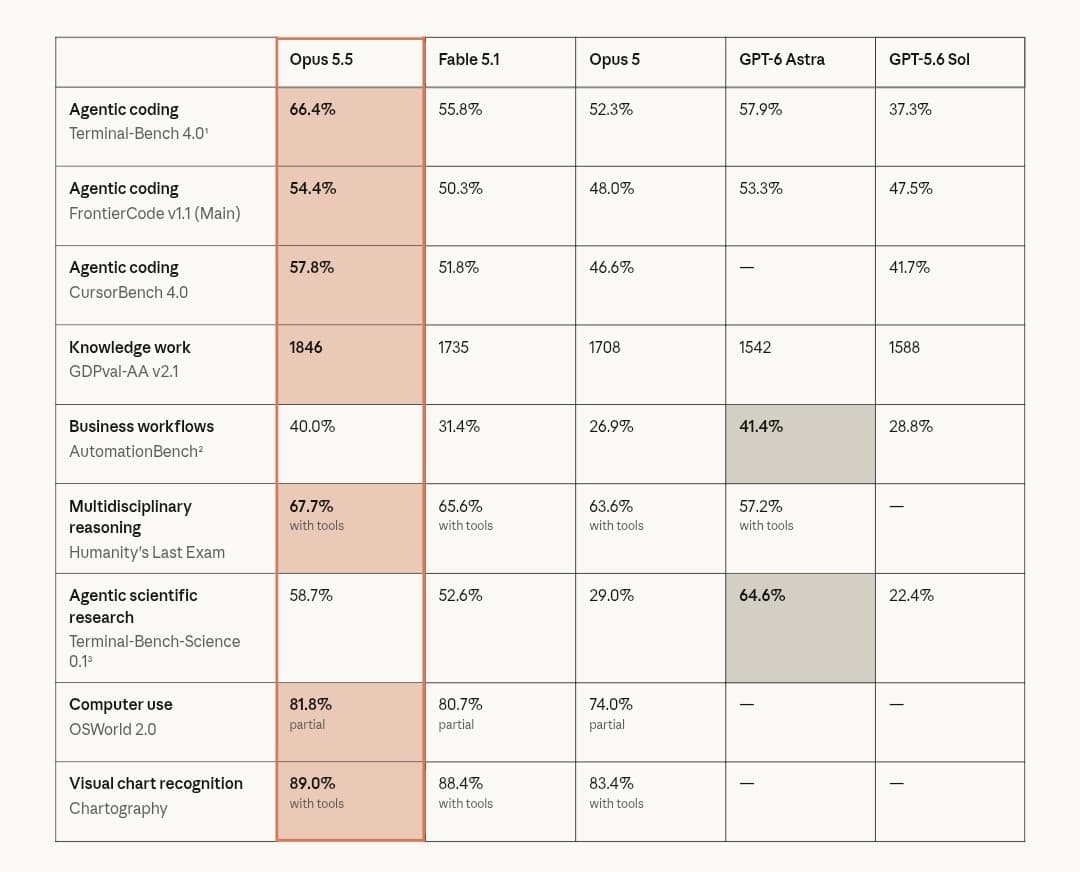
Claude Opus 5.5 est le premier membre de la nouvelle lignée 5.5. Sa conception repose sur une optimisation poussée qui lui permet d'égaler les performances de Claude Fable 5.1 sur la majorité des tâches complexes, tout en étant nettement plus efficace que l'ancien Opus 5.
L'accent a été mis sur la réduction de la latence et l'efficacité opérationnelle. Contrairement aux modèles précédents qui privilégiaient la force brute, Opus 5.5 utilise des techniques d'optimisation de l'inférence qui permettent de maintenir une fenêtre de contexte massive tout en réduisant l'empreinte énergétique et financière pour les développeurs.
- Performance équivalente à Claude Fable 5.1
- Optimisation de l'inférence pour des coûts réduits
- Architecture conçue pour la stabilité des agents autonomes
Performances de Codage : Des résultats sans précédent
Pour les ingénieurs, les chiffres parlent d'eux-mêmes. Lors des tests préliminaires, un utilisateur a réussi à effectuer une migration de code de 680 000 lignes en moins d'une journée grâce à Opus 5.5. C'est une prouesse qui transforme radicalement le cycle de vie du développement logiciel (SDLC).
Dans le domaine du développement d'applications web, le modèle a démontré une précision chirurgicale. Dans 39 tests sur 40, il a réussi à réduire les temps de chargement des applications web, là où l'Opus 5 échouait souvent en modifiant involontairement le comportement de l'application. De plus, il détient le score le plus élevé de tous les modèles Claude sur les tests de création de jeux en un seul prompt, notamment sur la qualité graphique et le polissage.