Actualités, tutoriels et perspectives sur l'IA
Benchmarks dual-GPU (2,39x), Flash Attention +171%, Q8 vs Q4, thinking budget 45 000 tokens, génération parallèle 2,91x.
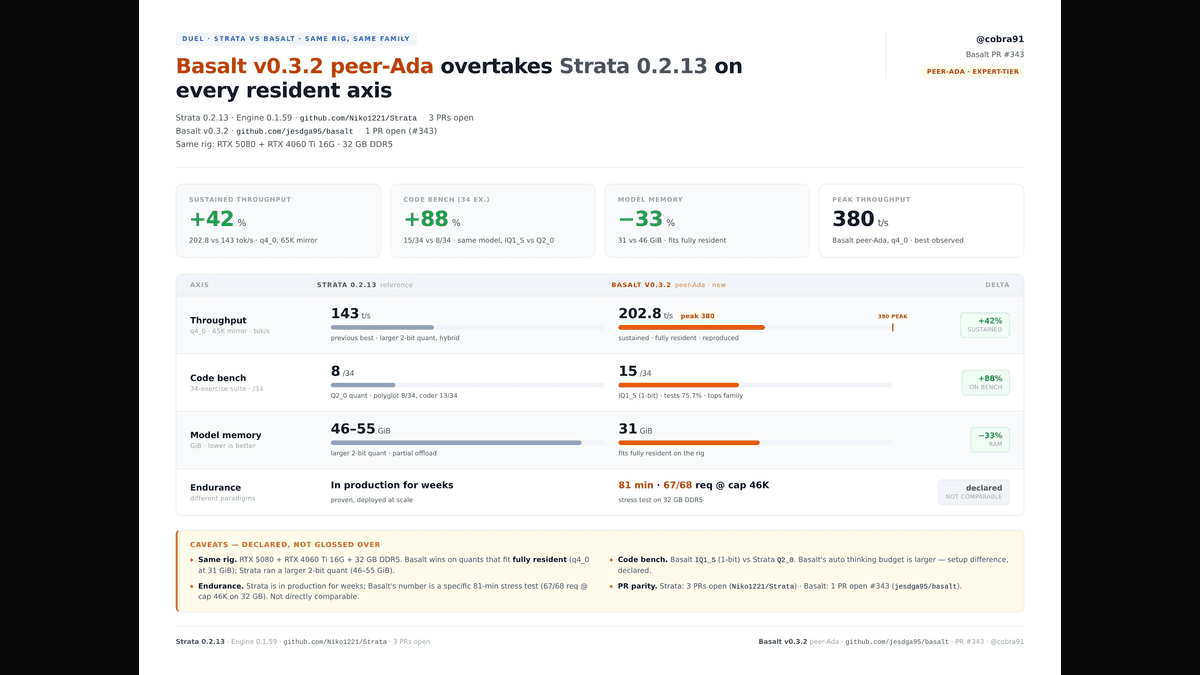
Même rig, builds frais, tiers vérifiés : Basalt atteint 161-174 tok/s réels contre 121,2 (207,5 contre 192,7 en bench, 348 en fixtures structurées) — une PR fait calculer la 4060 Ti, plus la découverte PCIe ×2 et le tuning par fixtures.
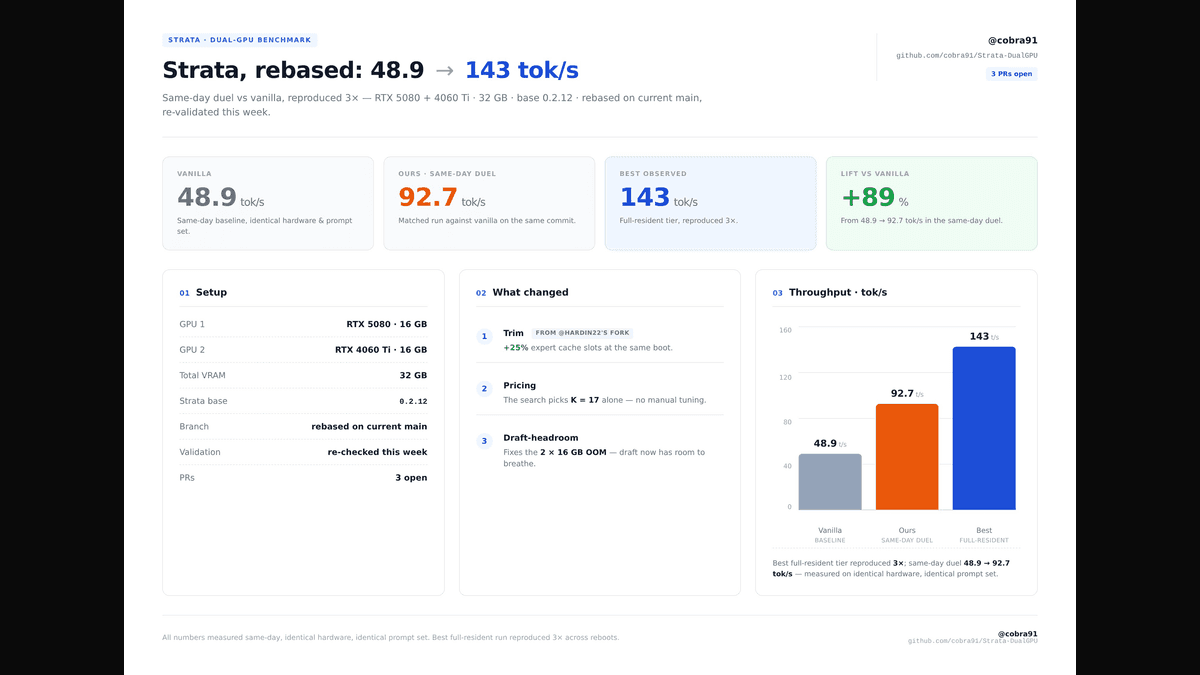
RTX 5080 + 4060 Ti : 34→143 tok/s sur un gros MoE via trois PRs documentées — chaque effet isolé mesuré, duels même-jour à tier égal, re-testées à chaque release.
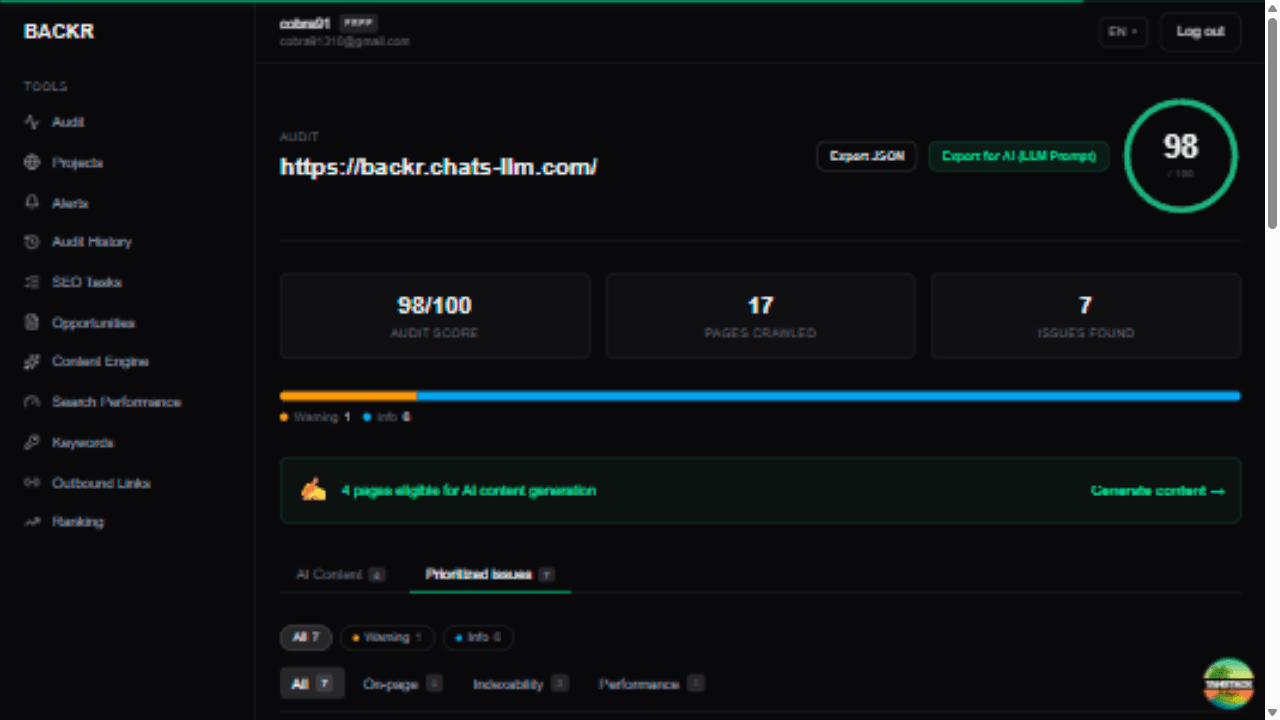
We ran BACKR, our free SEO audit tool, on chats-llm.com: 198 pages, 122 findings — and 11 that turned out to be the tool's fault, not the site's.
Unlock unified premium AI model access with our 2026 guide. Stop overpaying for separate AI tools and streamline your workflow for maximum productivity.
Une enquête sur la façon dont Claude Code d'Anthropic injecte des rappels système cachés qui consomment jusqu'à 50% de votre fenêtre de contexte, coûtant aux utilisateurs des millions de tokens à leur insu.