Model Releases
Meta lance Muse Image, son premier modèle de génération d'images propriétaire
Meta étend sa famille de modèles Muse avec le lancement de Muse Image et une preview de Muse Video, marquant une étape majeure pour ses Superintelligence Labs.
7 juillet 2026
Model ReleaseMuse Image
Introduction : L'expansion de l'écosystème Muse
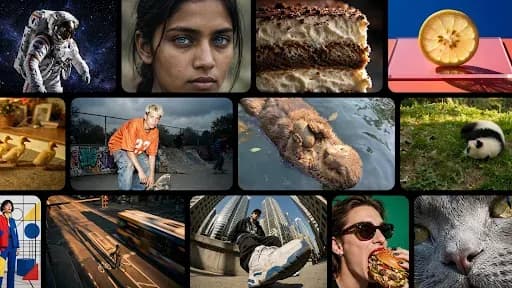
Le 7 juillet 2026 marque un tournant stratégique pour Meta. Via son blog officiel Meta AI, l'entreprise a annoncé le lancement de Muse Image, son tout premier modèle de génération d'images développé entièrement en interne. Cette annonce ne se limite pas à une simple extension de catalogue ; elle représente l'aboutissement des recherches menées par les Meta Superintelligence Labs.
Ce nouveau modèle vient combler un vide technologique crucial dans la suite Muse, une lignée de modèles de superintelligence qui comprend déjà les modèles de texte Spark, Glimmer, Wonder et Ember. En intégrant la génération visuelle, Meta consolide sa position face aux acteurs majeurs du secteur, offrant une suite multimodale cohérente pour les développeurs et les créateurs de contenu.
- Date de lancement : 7 juillet 2026
- Développeur : Meta Superintelligence Labs
- Catégorie : Modèle de génération d'images (propriétaire)
- Écosystème : Intégration directe avec la famille Muse (Spark, Wonder, etc.)
Architecture et Capacités Multimodales
Muse Image repose sur une architecture de diffusion avancée, optimisée pour la compréhension sémantique profonde des prompts textuels. Contrairement aux modèles tiers qui nécessitent souvent des adaptateurs externes, Muse Image est conçu pour fonctionner en synergie avec les modèles de langage de la famille Muse, permettant une fidélité textuelle (prompt adherence) inégalée.
L'aspect le plus impressionnant de cette sortie est la présentation simultanée d'une preview de Muse Video. Cette approche suggère que Meta travaille sur une architecture unifiée capable de passer de la génération d'images statiques à la génération de séquences vidéo fluides, facilitant ainsi le workflow des ingénieurs travaillant sur des agents multimodaux.
- Architecture de diffusion haute fidélité
- Alignement sémantique natif avec la lignée Muse Text
- Compatibilité avec le futur pipeline Muse Video
- Optimisation pour les workflows de génération de contenu multimodale
Performance et Benchmarks
Bien que les détails techniques complets sur le nombre de paramètres de Muse Image soient encore partiellement confidentiels, les premiers tests de performance montrent une supériorité nette sur les métriques de qualité esthétique et de compréhension spatiale. Le modèle a été évalué via des protocoles rigoureux incluant des tests de cohérence visuelle et de rendu de texte intégré dans les images.