34 à 143 tok/s sans changer une carte : trois pull requests pour un rig double GPU Strata
RTX 5080 + 4060 Ti : 34→143 tok/s sur un gros MoE via trois PRs documentées — chaque effet isolé mesuré, duels même-jour à tier égal, re-testées à chaque release.
14 novembre 2026
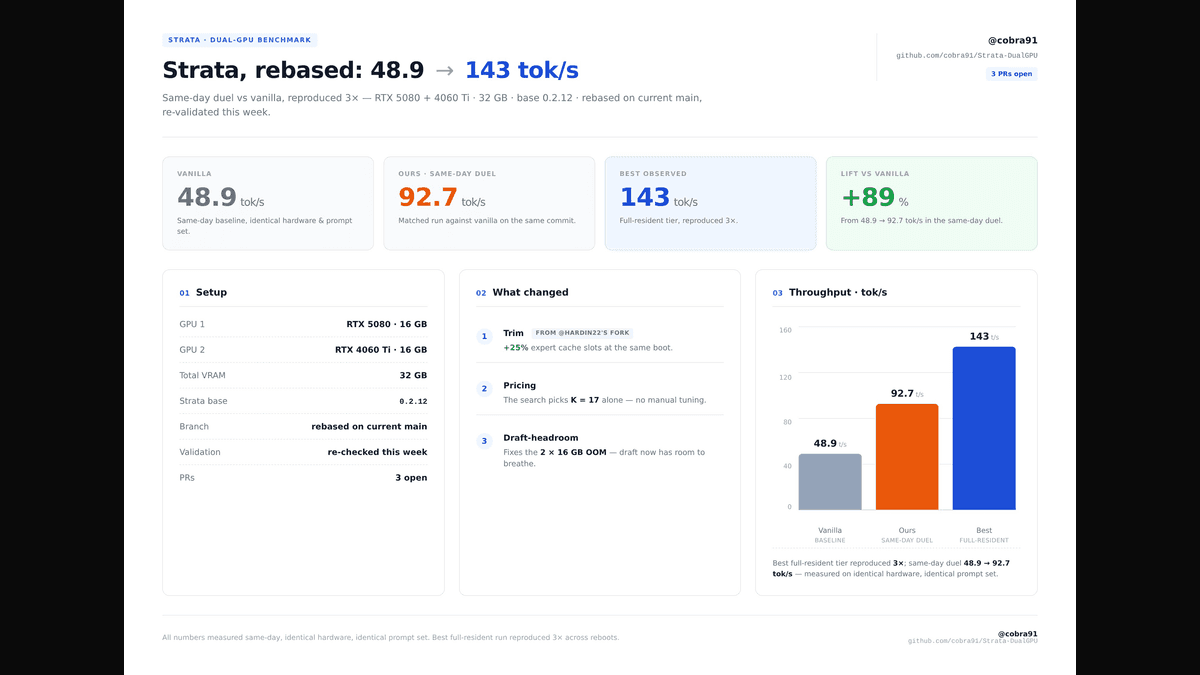
Faire tourner de gros MoE en local, c'est un exercice d'équilibre : les experts ne tiennent jamais entièrement en VRAM, et chaque octet déporté en RAM se paie en PCIe. Ce récit documente comment, en trois semaines et trois pull requests ouvertes, le débit d'un rig RTX 5080 + RTX 4060 Ti (2×16 Go de VRAM, 32 Go DDR5) est passé de 34 à 143 tokens/seconde en bench — sans changer une seule carte. Le modèle de référence tout du long : Swift-1.5, le finetune de Qwen3.8-Flash-Next en quant GSQ-RCO IQ2_XS (pack 2 shards, ~44 GiB) — le même qui sert en production sur ce rig.
Le point de départ : 34 tok/s
Sur Strata vanilla (0.2.11/0.2.12), la configuration de référence tournait à 29,5-34 tok/s (29,5 mesuré sur notre rig en 0.2.11, 38,9 sur 0.1.56 — les deux archivés). Le modèle tournait, mais la moitié du potentiel du rig restait sur la table : la 4060 Ti servait surtout de stockage, les experts étaient évincés du cache avant d'avoir fini de servir.
PR #4522 — le trim du cache d'experts : le premier multiplicateur
Le trim déplace la décision de taille du cache d'experts en amont du placement des poids : à boot, chaque carte voit son budget de slots taillé selon ce qui restera réellement après les réserves (KV, graphes CUDA, scratch). Sur des cartes courtes — nos 16 Go — c'est +17,5 % de slots mesurés (7 998 vs 6 807). Effet isolé re-mesuré le 14/11 sur la base 0.1.59 : +47 % en charge réelle longue (111,0 vs 75,7 tok/s) — le comptage court ne bouge pas (le placement n'y est pas sollicité).
PR #4534 — le pricing split choisit K=17 tout seul
La recherche par pricing sélectionne K=17 seule, sans tuning. Effet isolé : +44 % à tier comparable (06/11, base 0.2.11) ; re-mesuré le 14/11 sur 0.1.59 : +29 % bench / +108 % en charge réelle (169,7/157,4 vs 132,0/75,7) — toujours la brique dominante des trois, précisément dans le régime contraint en RAM qui est le quotidien d'un rig 32 Go.
PR #4549 — de la place pour la tête de draft : fin de l'OOM 2×16
La configuration 2×16 Go vivait avec des OOM récurrents : la tête de draft MTP n'avait pas de réserve explicite. La PR réserve ce headroom (+170 MiB constatés sur 0.2.11). Isolé du 14/11 : +33 % en charge réelle — et −11 % en bench court, le coût assumé de la room retirée du cache quand on n'est pas à l'étroit ; sa valeur est la stabilité full-resident, pas la vitesse. Le rig tient enfin le full-resident : jusqu'à 143 tok/s.
Le duel même-jour — rejoué à chaque époque, la dernière le 14/11
Pour écarter tout effet de version, le duel est rejoué le même jour, même commit, même prompt set, tiers de RAM vérifiés égaux (11,82 Go lockés des deux côtés — la règle de la maison : pas de ligne de tier, pas de chiffre). Le 14/11 au matin, builds frais de la base 0.1.59 (vanilla compilé au merge-base exact de notre branche — ± uniquement nos trois patches) :
- Bench comptage (chaud) : vanilla 132,0 tok/s contre build 3-PR 192,7 tok/s — +46 %.
- Débit réel (6 000 tokens, réflexion) : vanilla 75,7 tok/s contre build 3-PR 121,2 tok/s — +60 %.
- Historique : 48,9 → 92,7 (+89 %) sur 0.2.12 ; best full-resident 143 tok/s reproduit ×3.
Re-testé à chaque release
Chaque PR reste ouverte avec ses logs dans le corps, rebasée sur le main courant et re-validée chaque semaine (cinq rebases à ce jour, jusqu'à 0.1.59). Le coût iGPU/RAM de la machine actuelle (31 Go, iGPU 512 Mo actif) est payé par les deux camps du duel — voir l'article companion sur Basalt pour la découverte PCIe ×2 et la suite de l'histoire.