La 4060 Ti a appris à calculer : Basalt dépasse Strata sur notre rig — preuves et protocole
Même rig, builds frais, tiers vérifiés : Basalt atteint 161-174 tok/s réels contre 121,2 (207,5 contre 192,7 en bench, 348 en fixtures structurées) — une PR fait calculer la 4060 Ti, plus la découverte PCIe ×2 et le tuning par fixtures.
14 novembre 2026
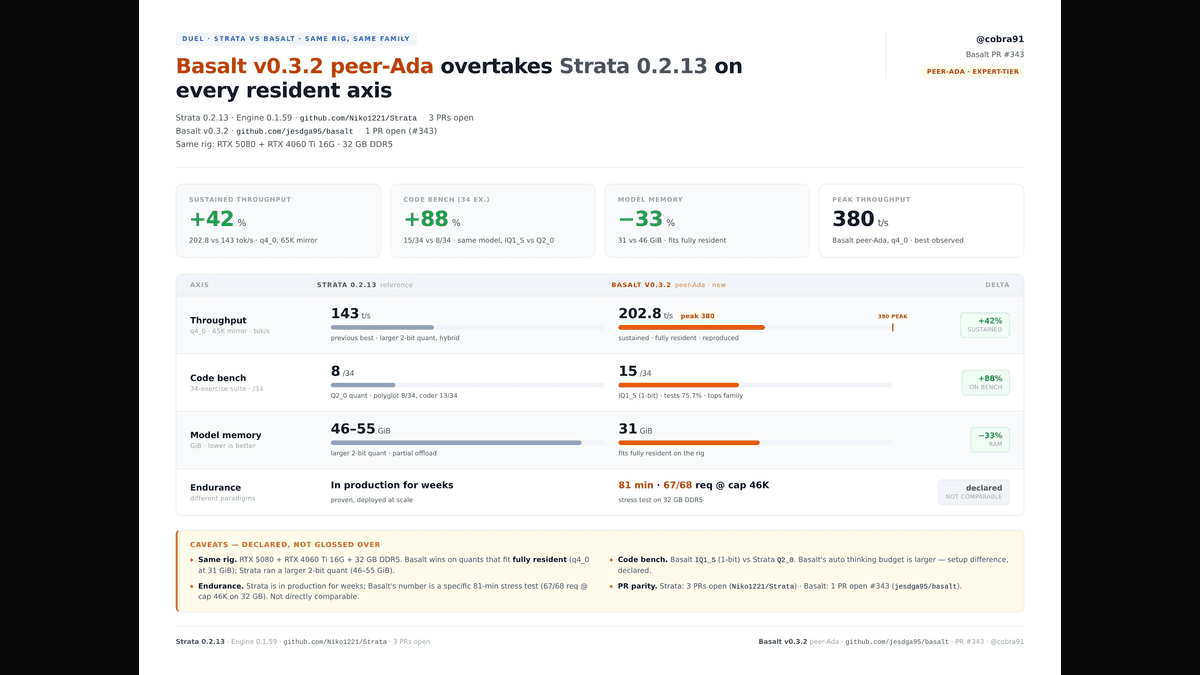
Il y a deux façons de comparer des moteurs d'inférence locaux : lire des benchmarks, ou en écrire. Cette comparaison vient d'un rig RTX 5080 + RTX 4060 Ti (2×16 Go) + 32 Go DDR5, avec une particularité assumée : son auteur a des pull requests ouvertes des deux côtés — trois chez Strata (#4522, #4534, #4549), une chez Basalt (#343). Chaque différence de setup est déclarée.
Avant : une carte de plus, zéro calcul de plus
Les kernels « peer » de Basalt n'avaient jamais été compilés pour sm_89 — l'architecture Ada de la 4060 Ti. En pratique, la carte n'était qu'un tier de VRAM lu à travers PCIe : du stockage, pas du calcul. Le travail MoE reposait entier sur la 5080.
La PR #343 : compiler les kernels peer pour Ada
Le fork autorise les peers sm_89/sm_120, compile les kernels peer/MMQ et le path prompt complet pour Ada, avec clusters/TMA exclus sous sm_90. Résultat : la 4060 Ti calcule désormais nativement les fenêtres d'experts MoE — Q8_1/Q2_0 en dp4a. Une carte « stockage » devient un tier de calcul à 14,5 GiB. Ce seul changement explique le basculement : 50,5 → 164 tok/s dès la première session.
La nuit du réglage : tuer les crashes en déplaçant le KV
Les crashes de longues conversations avaient une cause surprenante : le moteur disait « other programs took 4,8 GiB » — mais aucun programme n'était lancé. C'était le moteur lui-même : le KV au-delà de la cellule 30 000, épinglé en RAM, mangeait la marge du garde-fou — et le garde-fou ne comptabilise pas ses propres allocations. La preuve différentielle : passer kv-resident à 42000 sans fermer le moindre programme a fait passer les requêtes cap-6000 de « roulette russe » à 4/4. Diagnostic remonté au projet (issue #353).
Le tuning par fixtures officielles : trois leviers, chacun mesuré
Le protocole basalt-probe + basalt-bench (fixtures conv/struct/prose, ABAB) a révélé puis validé trois leviers :
- La 4060 Ti est sur un slot PCIe 4.0 ×2 — 3,2 Go/s contre 28,9 pour la 5080. Le fait était visible dans chaque dashboard (Gen4x2) sans jamais être remarqué. Conséquence : geler ses swaps d'adaptation (--peer-adapt-swaps 0) — la carte garde ses 11 194 experts les plus chauds et n'engorge plus son bus ; la 5080 continue d'adapter à pleine bande.
- spec 4 → 8 : sur le contenu structuré (JSON, code, raisonnement pas-à-pas), l'acceptance du drafter dépasse 95 % — les fixtures structurées passent de 237 à 348 tok/s (+47 %).
- Fix de pool PR #328 (un réveil perdu dans la barrière des workers CPU) : +11 % sur la prose — les micro-stalls de 10 ms disparaissent.
Et un contre-résultat utile : le KV NVFP4 (#314, 0,55 Go) perd contre l'int8 en vitesse à 65K (297 vs 348 structuré) — il reste l'arme du 131K+.
Les chiffres — builds frais, même matinée du 14/11, charge long-thinking
- Débit réel (prompt technique, réflexion, temp 0) : Strata 0.1.59 3-PR 121,2 tok/s — Basalt final 161-174 tok/s.
- Bench comptage (chaud) : Strata 192,7 tok/s — Basalt 207,5 tok/s.
- Fixtures officielles (conv/struct/prose) : 157 / 348 / 146 tok/s.
- Prefill 16K : 1 393 tok/s.
- Recette finale : kv int8 élastique, spec 8, pool 7, peer-adapt-swaps 0 (PCIe ×2), budget 8,15, réserves 256/128. Séquence cap-6000+image+texte passe 5/5 (174/161/164/161 t/s).
Le protocole du duel
- Même soirée, même machine (iGPU 512 Mo actif, 30,9 Go RAM), builds des deux moteurs compilés le jour même.
- Deux types de contenu étiquetés : comptage (~99 %) et réel-réflexion (59-66 %) — les deux reportés, jamais mélangés.
- Froid et chaud distingués ; l'ordre de lancement est une variable (les deux moteurs figent leur tier sur la RAM libre au boot).
- Ligne de tier vérifiée au boot ; garde RAM 2 Go = plancher anti-mort.
La mémoire : −33 %, et full-resident
Là où la config Strata de référence déploie un quant 2-bit plus large (~44 GiB, offload partiel), le Basalt final tient en 31 GiB, entièrement résident. Moins de RAM modèle, moins de PCIe, plus de calcul local.
Le bench code : le 1-bit qui bat le 2-bit
Sur notre suite de 34 exercices (polyglot, temp 0, pytest juge), même modèle : Basalt IQ1_S 15/34 (75,7 %) contre Q2_0 8/34. Déclaré : thinking budget ~34 500 vs 4096 ; le duel à budget égal reste à courir.
L'endurance : l'axe non comparable (assumé)
Strata tourne en production depuis des semaines. Basalt final a un stress test dédié : 81 minutes, 67/68 requêtes à cap 46K. Ces deux faits ne se comparent pas.
Verdict par usage
- Débit réel long-thinking : Basalt final, 161-174 contre 121,2 tok/s (Strata 3-PR, même matinée, tier égal).
- Production longue durée éprouvée : Strata, aujourd'hui.
- Les leçons dépassent les deux moteurs : vérifiez que vos kernels compilent pour l'architecture de votre seconde carte — et lisez la ligne PCIe de vos dashboards : un slot ×2 discret a limité cette carte pendant des semaines.
Reproduire
Basalt final (fork peer-ada, PR #343) : basalt_serve.json — modèle Qwen3.8-FN-UD-IQ1_S sur GPU 0,1, kv int8, max-context 65536, vision dynamic ; engine : resident-experts true, pool-workers 7, spec 8, expert-cache auto, prefill auto, resident-budget-gib 8.15, peer-adapt-swaps 0, vram-reserve-mib 256, peer-reserve-mib 128. Vérifier au boot : « experts live in ... file (SSD) 0.0 GiB » et « RAM X GiB free, guard 2.00 GiB ».
Strata hybride 0.1.59 (3 PRs) : STRATA_RESIDENT_HEADROOM_GIB=4, python serve/server.py --engine strata --config engine_swift_prod.json --port 18503. Bench code : python polyglot_runner.py --name <run> --url http://127.0.0.1:8644/v1 --model « Qwen3.8-Flash-Next UD-IQ1_S » (pytest juge).