От 34 до 143 токенов/с без замены видеокарты: три Pull Request для двухпроцессорной конфигурации Strata
RTX 5080 + 4060 Ti: 34→143 токенов/с на большой MoE через три задокументированных PR — каждый изолированный эффект измерен, дуэли в тот же день при равном уровне памяти, повторное тестирование при каждом релизе.
14 ноября 2026 г.
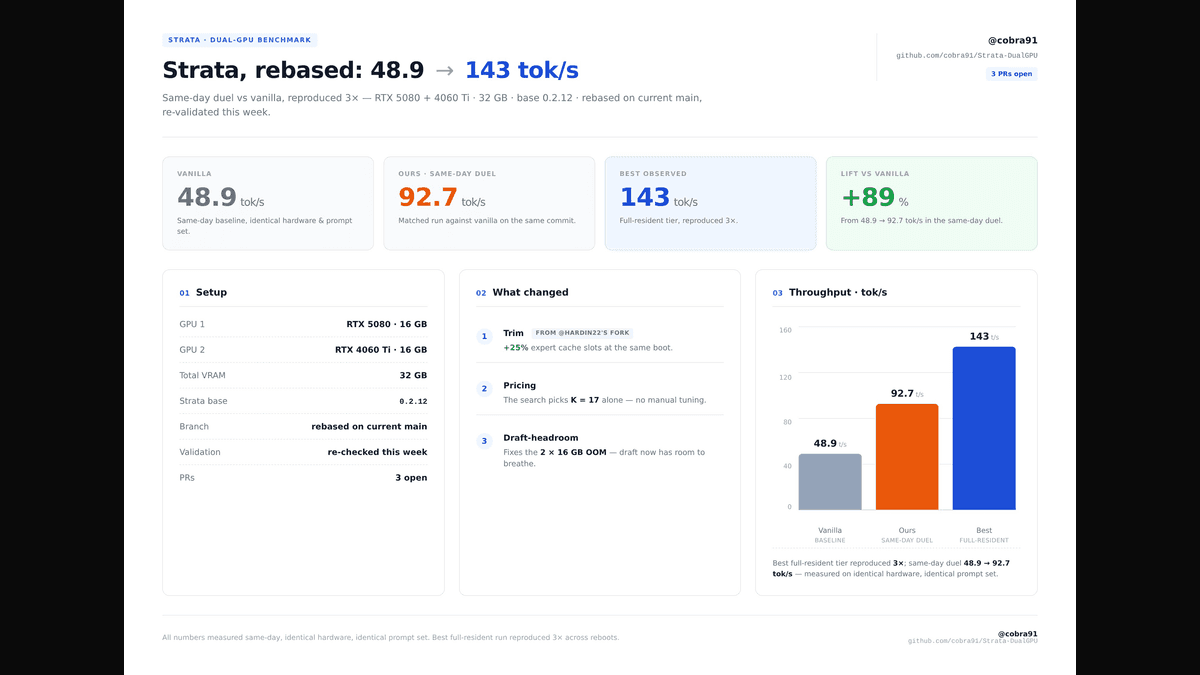
Запуск больших MoE-моделей локально — это поиск баланса: эксперты никогда не помещаются в VRAM целиком, и каждый байт, выгруженный в RAM, оплачивается задержками через PCIe. Это история о том, как за три недели и три открытых pull request пропускная способность системы на базе RTX 5080 + RTX 4060 Ti (2x16GB VRAM, 32GB DDR5) выросла с 34 до 143 токенов в секунду в бенчмарках — без замены ни одной видеокарты. Эталонная модель на протяжении всего теста: Swift-1.5, finetune Qwen3.8-Flash-Next в квантовании GSQ-RCO IQ2_XS (2-shard pack, ~44 GiB) — та же самая, что работает в продакшене на этой системе.
Точка отсчета: 34 tok/s
На ванильной Strata (0.2.11/0.2.12) эталонная конфигурация работала на скорости 29.5-34 tok/s (29.5 измерено на нашей системе на 0.2.11, 38.9 на 0.1.56 — обе версии в архиве). Модель работала, но половина потенциала системы оставалась неиспользованной: 4060 Ti в основном служила хранилищем, а эксперты вытеснялись из кэша до завершения своей работы.
PR #4522 — обрезка кэша экспертов: первый множитель
Обрезка переносит решение о размере кэша экспертов на этап выше размещения весов: при загрузке бюджет слотов каждой карты урезается до того объема, который фактически останется после резервов (KV, CUDA graphs, scratch). На коротких картах — наших 16GB — это дает +17.5% измеренных слотов (7,998 против 6,807). Изолированный эффект переизмерен 14 ноября на 0.1.59: +47% на реальной рабочей нагрузке (111.0 против 75.7 tok/s) — результаты коротких тестов на подсчет не изменились (там размещение не подвергается нагрузке).
PR #4534 — ценообразование split pricing само по себе выбирает K=17
Поиск на основе ценообразования выбирает K=17 без дополнительной настройки. Изолированный эффект: +44% на сопоставимом уровне (6 ноября, база 0.2.11); переизмерено 14 ноября на 0.1.59: +29% в бенчмарке / +108% в реальной нагрузке (169.7/157.4 против 132.0/75.7) — это все еще доминирующий фактор из трех, именно в режиме ограниченной RAM на системе с 32GB.
PR #4549 — место для draft head: конец эпохи OOM на 2x16GB
Конфигурация 2x16GB страдала от регулярных OOM: у MTP draft head не было явного резерва. PR резервирует этот запас (+170 MiB в наблюдении). Изолированный эффект 14 ноября: +33% в реальности — и -11% в коротком бенчмарке, что является ожидаемой ценой за место, взятое из кэша; его ценность заключается в стабильности при полной резидентности, а не в скорости. Система наконец-то держит полную резидентность: до 143 tok/s.
Дуэль в один день — повторяется при каждом релизе, последний раз 14 ноября
Тот же день, тот же коммит, тот же набор промптов, подтвержденные равные уровни RAM (заблокировано 11.82 GB с обеих сторон — правило дома: нет линии уровня — нет цифры). Утро 14 ноября, свежие сборки на базе 0.1.59 (ванильная скомпилирована точно на merge-base):
- Бенчмарк подсчета (warm): ванильная 132.0 против сборки с 3-PR 192.7 tok/s — +46%.
- Реальная пропускная способность (6,000 токенов, reasoning): ванильная 75.7 против сборки с 3-PR 121.2 tok/s — +60%.
- История дуэлей: 48.9 → 92.7 (+89%) на 0.2.12; лучший результат полной резидентности 143 tok/s воспроизведен 3 раза.
Перепроверка при каждом релизе
Каждый PR остается открытым с логами в теле, перебазируется на текущий main и еженедельно перепроверяется (на данный момент пять ребазов, до версии 0.1.59 включительно). Затраты iGPU/RAM текущей машины (31GB, активно 512MB iGPU) оплачиваются обеими сторонами дуэли — см. сопутствующую статью на Basalt об обнаружении PCIe ×2 и полную историю.