4060 Ti научилась вычислять: Basalt обходит Strata на нашем стенде — доказательства и протокол
Тот же стенд, новые сборки, проверенные уровни: Basalt достигает 161-174 реальных tok/s против 121.2 у Strata (207.5 против 192.7 в бенчмарке, 348 структурированных фикстур) — благодаря одному PR, который заставляет 4060 Ti вычислять, а также обнаружению PCIe ×2 и тюнингу на основе фикстур.
14 ноября 2026 г.
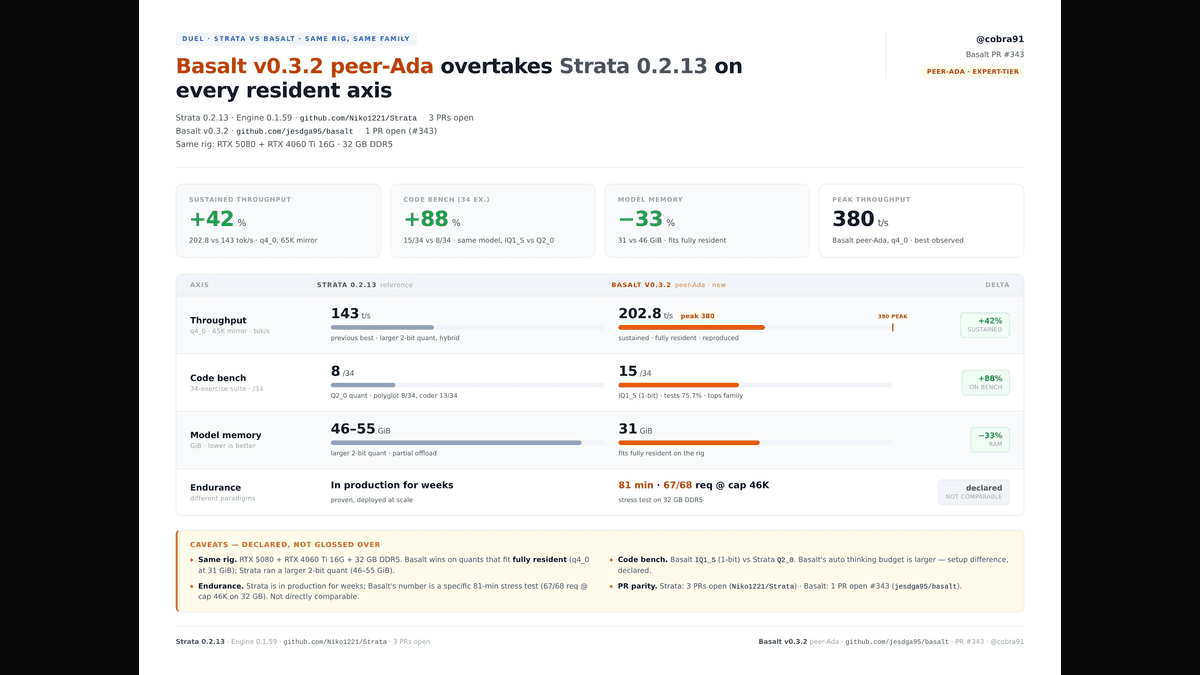
Существует два способа сравнить локальные движки инференса: читать бенчмарки или писать их самостоятельно. Данное сравнение основано на конфигурации RTX 5080 + RTX 4060 Ti (2x16GB) + 32GB DDR5, с одной заявленной особенностью: автор имеет открытые pull requests в обеих ветках — три в Strata (#4522, #4534, #4549) и один в Basalt (#343). Любое различие в настройках задекларировано.
До: еще одна карта, ноль дополнительной вычислительной мощности
«Peer»-кернелы Basalt никогда не компилировались под sm_89 — архитектуру Ada в 4060 Ti. На практике карта служила лишь уровнем VRAM, считываемым через PCIe: хранилище, а не вычисления. Работа MoE полностью ложилась на 5080.
PR #343: компиляция peer-кернелов для Ada
Форк позволяет использовать sm_89/sm_120 peers, собирает peer/MMQ-кернелы и полный путь промпта для Ada, при этом clusters/TMA исключаются (compiled out) для архитектур ниже sm_90. Результат: 4060 Ti теперь нативно вычисляет окна экспертов MoE — Q8_1/Q2_0 через dp4a, стандартный CUDA. «Карта-хранилище» превращается в вычислительный уровень на 14.5 GiB. Это единственное изменение объясняет скачок: с 50.5 до 164 tok/s в первой сессии, еще до какой-либо настройки.
Ночь настройки: устранение вылетов путем переноса KV
Вылеты при длинных диалогах имели неожиданную причину: движок сообщал, что «другие программы заняли 4.8 GiB», хотя никакие программы не были запущены. Это был сам движок: KV за пределами 30 000 ячеек, закрепленный в RAM, съедал запас watchdog при каждом длинном разговоре — а watchdog не учитывает собственные аллокации. Дифференциальное доказательство: перенос kv-resident на 42000 (KV в VRAM, резерв GPU на 256) без закрытия ни одной программы превратил результаты cap-6000 запросов из «русской рулетки» в 4/4. Полный диагноз был передан upstream (issue #353).
Настройка по официальным фикстурам: три рычага, каждый измерен
Протокол basalt-probe + basalt-bench (фикстуры conv/struct/prose, ABAB) выявил и подтвердил три рычага управления:
- 4060 Ti работает на слоте PCIe 4.0 ×2 — 3.2 GB/s против 28.9 у 5080. Это видно в каждом дашборде (Gen4x2), но раньше никто не замечал. Последствие: заморозка адаптивных свопов (--peer-adapt-swaps 0) — карта удерживает свои 11,194 самых «горячих» экспертов и больше не перегружает собственную шину; 5080 продолжает адаптацию на полной пропускной способности.
- spec 4 → 8: на структурированном контенте (JSON, код, пошаговые рассуждения) принятие черновиком (drafter acceptance) превышает 95% — более длинное окно верификации составляет в среднем 6.8 токена за цикл: структурированные фикстуры прыгают с 237 до 348 tok/s (+47%).
- Исправление пула PR #328 (пробуждение, потерянное в барьере CPU worker): +11% на prose — микро-задержки в 10 мс исчезли.
И полезный побочный результат: KV NVFP4 (#314, 0.55 GiB) проигрывает int8 при контексте 65K (297 против 348 структурированных) — он остается инструментом для контекстов 131K+.
Цифры — свежие билды, то же утро 14 ноября, нагрузка long-thinking
- Реальная пропускная способность (технический промпт, рассуждение, temp 0): Strata 0.1.59 3-PR 121.2 tok/s — Basalt final 161-174 tok/s.
- Счетный бенчмарк (warm): Strata 192.7 tok/s — Basalt 207.5 tok/s.
- Официальные фикстуры (conv/struct/prose): 157 / 348 / 146 tok/s.
- Prefill 16K: 1,393 tok/s.
- Финальный рецепт: kv int8 elastic (все в VRAM), spec 8, pool 7, peer-adapt-swaps 0 (4060 Ti на PCIe ×2), budget 8.15, reserves 256/128. Последовательность cap-6000+image+text проходит 5/5 (174/161/164/161 t/s).
Протокол дуэли (что делает числа сопоставимыми)
- Тот же вечер, та же машина (активная iGPU 512MB, 30.9 GB RAM), оба движка скомпилированы в один день.
- Два маркированных типа контента: counting (принятие черновиком ~99%) и real-reasoning (59-66%) — оба зафиксированы, никогда не смешивались.
- Разделение на cold и warm; порядок запуска является переменной (оба движка фиксируют свой уровень на основе свободной RAM при загрузке).
- Линия уровня (tier line) проверяется при загрузке ("file (SSD) 0.0 GiB" = валидно); guard 2GB RAM = защитный порог от падения.
Память: -33%, и полностью резидентна
Там, где эталонная конфигурация Strata развертывает более крупный 2-битный квант (~44 GiB, частичный offload), Basalt final умещается в 31 GiB, полностью находясь в памяти. Меньше RAM для модели, меньше нагрузки на PCIe, больше локальных вычислений.
Кодовый бенчмарк: 1-бит, который побеждает 2-бит
На нашем наборе из 34 упражнений по коду (полиглот, temp 0, pytest в роли судьи), та же базовая модель: Basalt IQ1_S 15/34 — 75.7% тестов пройдено, лучший результат семейства на этом наборе — против 8/34 для Q2_0 на Strata. Заявлено: бюджет на автоматическое мышление у Basalt больше (~34,500 против 4096); дуэль с равным бюджетом еще предстоит провести.
Выносливость: несопоставимая ось (предположительно)
Strata работает в продакшене неделями. Basalt final прошел выделенный стресс-тест: 81 минута, 67/68 запросов с лимитом 46K. Эти два факта не сопоставимы — и в статье об этом сказано.
Вердикт по сценариям использования
- Реальная пропускная способность long-thinking на этой сборке: Basalt final, 161-174 против 121.2 tok/s (Strata 3-PR, то же утро, равный уровень).
- Проверенная длительная работа в продакшене: Strata, сегодня.
- Уроки выходят за рамки обоих движков: убедитесь, что ваши кернелы компилируются под архитектуру вашей второй карты — и проверяйте линию PCIe в ваших дашбордах: дискретный слот ×2 ограничивал эту карту неделями, и никто этого не замечал.
Воспроизведение
Basalt final (peer-ada fork, PR #343): basalt_serve.json — model Qwen3.8-FN-UD-IQ1_S on GPU 0,1, kv int8, max-context 65536, vision dynamic; engine: resident-experts true, pool-workers 7, spec 8, expert-cache auto, prefill auto, resident-budget-gib 8.15, peer-adapt-swaps 0, vram-reserve-mib 256, peer-reserve-mib 128. Проверить при загрузке: "experts live in ... file (SSD) 0.0 GiB" и "RAM X GiB free, guard 2.00 GiB".
Strata hybrid 0.1.59 (3 PRs): STRATA_RESIDENT_HEADROOM_GIB=4, python serve/server.py --engine strata --config engine_swift_prod.json --port 18503. Bench code: python polyglot_runner.py --name <run> --url http://127.0.0.1:8644/v1 --model "Qwen3.8-Flash-Next UD-IQ1_S" (pytest as judge).